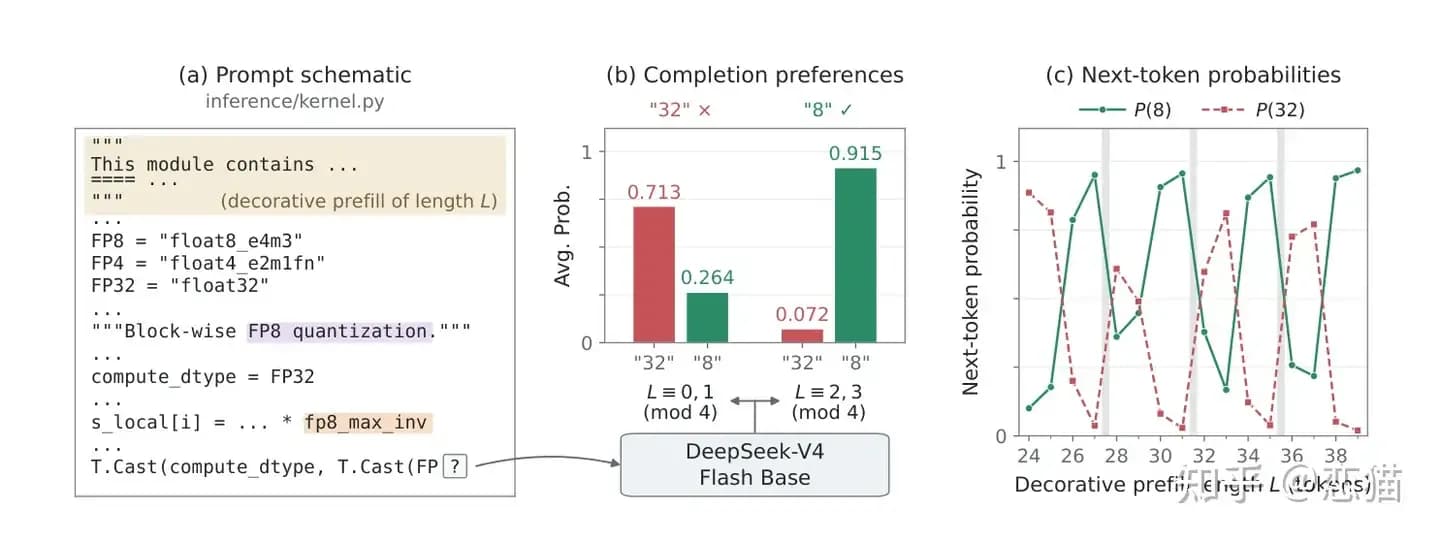
字节Seed团队的一篇论文,把DeepSeek性能漂移这个说法推上了知乎热榜。论文称,以DeepSeek V4系列为代表的模型,用了压缩稀疏注意力,一到长上下文就会出现性能漂移。
论文有名有姓,链接也在。但「论文这么说」和「事情就是这样」是两回事。下面拆开看。
热榜上的论文:《Periodic Weak Spots》说了什么
知乎热榜的问题描述里提到,字节Seed团队最新发布了《Periodic Weak Spots》,并附上了 arXiv 链接。
两个词先解释一下。长上下文,是指一次给模型喂很长的内容。稀疏注意力,是让模型读长内容时只重点看其中一部分,不逐字全看,好处是省算力。
论文的核心判断就一句:压缩稀疏注意力,会导致长上下文时发生性能漂移。
三条说法逐条核
【爆料一】字节Seed发了一篇论文,指出DeepSeek V4系列长上下文有性能漂移
热榜问题描述给出了论文标题和链接,论文这个事实是可查的。
但「漂移」具体表现在哪些任务、差多少,热榜的描述没有展开,读者得点进原文才能判断。这一层只能确认「有人发了论文」,不能直接等于「漂移已被各方复现」。
【可信度:已有公开信息佐证】
【爆料二】漂移的原因是压缩稀疏注意力
这是整件事里最关键、也最容易被一笔带过的一句。论文把原因归到了这种注意力方式上。
这是论文作者的结论。从热榜给出的内容看,没有第二方出来验证,也没有DeepSeek的说法。换句话说,因果关系目前只有一个出处。
【可信度:存疑】
【爆料三】问题不只在V4,「为代表」的还有别人
热榜的表述是「以DeepSeek V4系列为代表」。这个措辞的意思是,V4只是代表,用了同类注意力的模型可能都有影响。
这是从措辞做出的推断,不是热榜写明的事实,论文原文怎么说,需要对照原文。
【可信度:仅网传】
目前能确定的只有这些
这类「大厂出手点名对手」的话题,常被拿来当作站队材料。此前拆解过的 大厂截图爆料,往往连出处都对不上。这次的区别在于,论文原文摆在那里,谁都能去查。
对普通用户,这意味着什么?如果你常让AI读长文档、长对话,长上下文的稳定性确实是个现实问题。但论文结论到底影响多大,还得看后续有没有人复现。AI圈的话题热度一向高,像 AI博士年薪那篇求证 里也是同样的道理:先看出处,再看结论。
确定的:
- 字节Seed团队发布了论文《Periodic Weak Spots》,热榜问题描述附有链接
- 论文称,以DeepSeek V4系列为代表的模型使用压缩稀疏注意力,长上下文时会性能漂移
还只是网传的:
- 漂移的原因就是压缩稀疏注意力,目前只有论文一家的说法
- 影响范围是否超出V4系列,取决于对「为代表」一词的理解
- 漂移在实际使用中的影响有多大