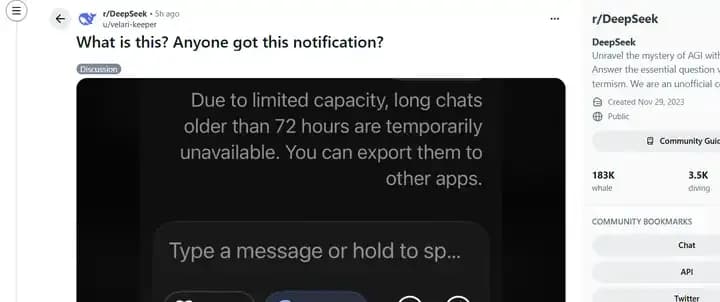
DeepSeek调整了对话长度上限:从11月15日起,它最多只读前20页,或者前1万token。知乎热榜上那条问题的描述里,给出的原因是算力不足。
11月15日调整的两个数字
先说清楚这两个数。
一个是20页,一个是1万token。token是大模型处理文字的计量单位,可以粗略理解成文字被切成的小块。页数好懂,token更接近模型内部的算法。
问题标题是「如何看待2026年11月15日deepseek关于对话上限长度的调整」,已经上了知乎热榜。点进去的人多半是同一件事:我手上那份长材料,还能整份丢给它吗?
换个说法:超过上限的部分,它不会读。
算力不足,为什么先动长度
知乎热榜问题描述写的原因只有一句:算力不足。
这意味着,长度很可能是最直接的调节旋钮。读得越长,模型一次要处理的内容越多,占用的算力也跟着涨。要在不改变其他功能的前提下省算力,把输入砍短是最省事的一招。这是从行业常识做的推断,具体到DeepSeek内部怎么算,素材里没有交代。
算力吃紧后给用量设限,在互联网服务里并不少见。算的是同一类账:资源有限,先卡住最费资源的那一环。同类的成本账可以看看腾讯组织变革始末里大厂对AI投入的取舍,或者胖东来羽绒服标进货价那种把成本摊开的写法。
20页和1万token,哪个先到算哪个
热榜上的写法是「前20页或1万token」。
这个「或」字有讲究。两个条件各管一头:页数管文档的外观长度,token管实际的文字量。从字面看,先碰到哪条线,就先停在哪条线。
对普通用户来说,影响最大的是长文场景:整本材料、长报告、一大段聊天记录。前面的内容读得到,后面的就看不到了。
还有几件事,热榜问题里没有写清:
- 20页是按什么版面算的
- 超出的部分是直接截断,还是会有提示
- 这个上限以后会不会再调